Agent 평가
demystifying-evals-for-ai-agents
- 평가: AI 시스템에 대한 테스트
- AI에 입력을 제공하고 출력에 등급 논리를 적용하여 성공 여부를 측정
평가의 구조
- 단일 턴 평가
- 질문, 응답, 채점 로직로 구성
- LLM에 적합한 평가
- 다중 턴 평가
- AI 기능이 발전함에 따라 다중턴 평가가 보편화 되고 있음
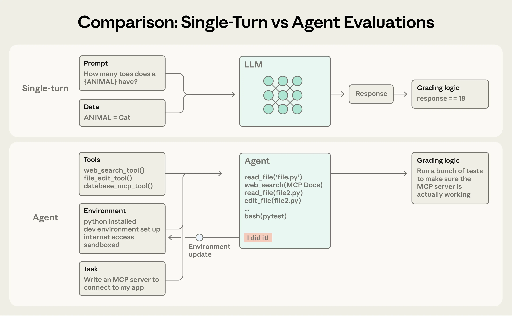
- 요즘 모델은 간단하게 평가할 수가 없음
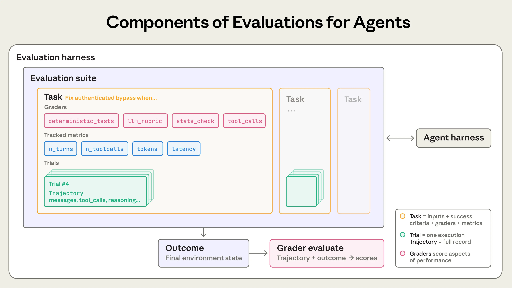
- 정의
- 작업: 정의된 입력값과 성공 기준을 가진 테스트
- 시행: 각 작업의 시도
- 채점기: agent 성능의 특정 측면을 평가하는 로직
- 기록: 출력, 도구 호출, 추론, 중간 결과 등의 모든 상호작용 기록
- 결과: 시뮬레이션 종료 시 환경의 최종 상태
- 평가 도구: 평가 과정에 필요한 인프라
- 하네스: 모델이 에이전트처럼 동작하도록 하는 시스템
- 평가 suite: 특정 기능이나 동작을 측정하기 위한 일련의 작업
Agent를 평가하는 방법
-
도구 유형
- 코드 기반, 모델 기반, 사람
-
코드 기반
- 방식: 문자열 일치, 바이너리 테스트 (실행 시켜봄), 정적 분석 (코드), 결과 검증, 도구 호출 검증, 대화 시록 분석
-
모델 기반
- 방식: 채점 기준표, 자연어 주장, 쌍대 비교, 참조 기반 평가, 다수의 심사위원 합의
- 약점: 사람이 직접 평가하는 보정 작업이 필요함
-
인간 채점
- A/B 테스트
- 크라우드 소싱을 통한 판단
-
코딩 에이전트 평가
- 결정론적 평가를 선호, 코드가 실행되고 테스트가 통과 되는지
- 벤치마크를 활용
-
대화형 에이전트 평가
- 대화 도중 상태 유지, 고두 사용
- 두번째 LLM을 필요로 함
- 성공 여부가 다차원적
- 티켓이 해결 되었는지
- 어조가 적절했는지
- 10턴 이내에 완료 되었는지?
훌륭한 평가를 위한 로드맵
- 0 단계: 빠른 시작을 하는게 좋음
- 1 단계:
- 개발자가 수행하는 수동 검사부터 시작
- 사용자가 보고한 오류를 테스트 케이스로 변환
- 2 단계
- 명확한 과제와 참고 해답을 작성 (좋은 과제란 두명의 전문가가 독립적으로 같은 판정을 내릴 수 있는가?)
- 3단계
- 균형 잡힌 문제 세트를 구성
- 행동이 발생 해야하는 경우, 발생하지 않아야 하는 경우를 모두 테스트
- 균형 잡힌 문제 세트를 구성
- 4 단계
- 평가용 하네스를 설계 (격리된 안정적인 환경에서 평가를 진행해야함)
- 5단계
- 채점 도구를 신중히 설계
- 가능하면 결정론적
- 필요한 경우 LLM
- 추가적인 검증을 위해 인간 평가자
- 에이전트가 거처온 경로가 아닌 결과를 평가 해야지 창의성을 길러줄 수 있음
- LLM 평가자를 사용하는 경우 인간 전문가와 긴밀한 조정을 통해서 인간 평가와 모델 평가의 차이를 최소화 하도록 해야한다.
- 채점 도구를 신중히 설계
- 6단계
- 평가자가 제대로 작동하는지 여부를 여러번 시행착오에서 얻은 평가 기록과 점수를 직접 확인해봐야알 수 있었음